
포스팅 개요
2026년 9월 15일, TypeSafe AI가 Jev라는 모델을 Early Access로 공개했습니다. TypeSafe는 Jev를 첫 번째 System One Model이라고 부릅니다. 이름만 보면 새로운 LLM이나 Agent Framework처럼 보이지만, Jev가 하려는 일은 조금 다릅니다.
Jev는 긴 답변을 작성하거나 코드를 생성하는 모델이 아닙니다. 현재 상태(State)를 입력받고, 개발자가 정의한 질문에 대해 선택하고, 점수를 매기고, 확률을 반환하는 판단(Decision)에 초점을 맞춘 모델입니다. TypeSafe가 공식 자료에서 사용하는 표현도 꽤 명확한데요. "unstructured state in, typed probabilistic decisions out", 즉 비정형 상태를 입력받아 타입이 정해진 확률적 판단을 반환한다는 것입니다.
이 설명만 보면 기존 Classifier나 Reranker와 크게 다르지 않아 보입니다. 실제로 검색 시스템의 Reranker도 Query와 후보 문서를 보고 각 후보에 점수를 부여한 뒤 순서를 정합니다. 후보 문서를 '실행 가능한 행동'으로 바꾸면 겉으로는 의사결정 모델과 상당히 비슷한 형태가 됩니다. 그렇다면 Jev는 기존 분류 모델을 새롭게 포장한 것일까요? 아니면 LLM과 다른 새로운 Architecture일까요?
이번 포스팅은 이 Jev란 무엇인지 알아보도록 하겠습니다.
핵심! Jev는 "더 짧게 답하는 LLM"이 아닙니다.
LLM이 주로 Text Generation을 위해 사용됐다면, Jev는 Software 안에서 반복되는 분류, 선택, 평가, Routing, 검증 같은 Decision을 직접 반환하는 것을 목표로 합니다. 그리고 Jev Engineering은 이 Decision Layer를 LLM과 Code 사이에 배치하는 설계 방식이라고 이해하면 가장 쉽습니다.
포스팅 본문
[1]. Jev란?
Jev는 TypeSafe AI가 만든 모델의 이름입니다. TypeSafe는 자신들이 만든 모델 계열을 System One Models라고 부르고, 그 첫 번째 공개 모델이 Jev라고 설명합니다. 2026년 9월 15일부터 Early Access 형태로 제공되고 있으며, 현재 개발자는 TypeSafe API와 공식 Python, JavaScript/TypeScript SDK를 통해 Jev를 호출할 수 있습니다.
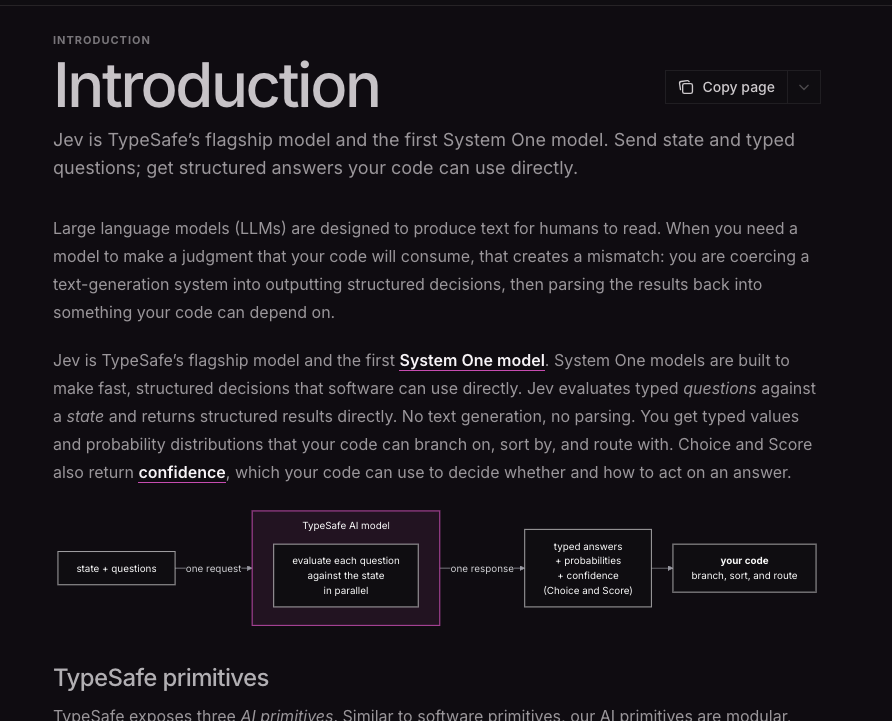
사용 방식만 보면 OpenAI나 Anthropic의 Model API와 비슷합니다. 하지만 요청과 응답의 형태가 다릅니다. 일반적인 LLM API에서는 Prompt나 Message를 전달하고 Model이 Text 또는 Structured Output을 생성합니다. Jev에서는 현재 상태(State)와 그 상태에 대해 판단하고 싶은 Questions를 전달합니다.
예를 들어 고객 문의가 들어왔다고 생각해보겠습니다. LLM에게 "이 문의를 분석해서 Billing, Technical, Other 중 하나를 JSON으로 출력해줘"라고 요청할 수도 있습니다. Jev에서는 애초에 가능한 선택지를 정의한 Choice Question을 보내고 그중 하나에 대한 판단을 받습니다. 우리가 필요한 것이 문장이 아니라 Routing Decision이라면, 처음부터 Decision 자체를 Model의 Output으로 사용하겠다는 접근입니다.
| 구분 | 일반적인 LLM | Jev |
| 주요 목적 | Text / Code / Structured Output 생성 | Software가 사용할 Decision 반환 |
| 입력 | Prompt, Message, Context | State + Questions |
| 출력 | Token으로 생성된 문자열 | Typed Decision + Probability / Confidence |
| 대표 작업 | 작성, 요약, 추론, 코드 생성 | 분류, 선택, 평가, Routing, 검증 |
| 실행 방식 | 일반적으로 Autoregressive Generation | TypeSafe 설명상 여러 Output을 병렬적으로 처리 |
[2]. 기존 Classifier나 Reranker와 무엇이 다른가?
Jev가 실제로 학습된 Model이라는 것을 알게 되면 자연스럽게 다음 질문이 생깁니다."그러면 결국 판단을 잘하도록 데이터를 학습시킨 Classifier 아닌가?" 큰 틀에서는 비슷한 부분이 있습니다. 사실 Machine Learning에서는 오래전부터 판단을 하는 모델이 있었습니다. Sentiment Classifier는 Positive, Neutral, Negative의 확률을 계산하고, Fraud Detection Model은 거래가 사기일 확률을 계산합니다. 검색 시스템의 Reranker도 Query와 후보 문서를 보고 각 문서에 Relevance Score를 부여합니다.
다만 Jev를 단순히 "조금 더 좋은 Classifier"라고 생각하면 중요한 차이를 놓치게 됩니다. 가장 먼저 봐야 하는 것은 모델이 어떤 Task를 수행하도록 학습되었는가입니다.
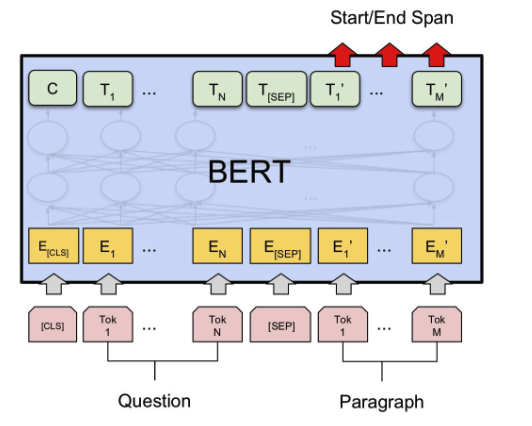
전통적인 Classifier를 예로 들어보겠습니다. 어떤 문서를 High / Medium / Noise로 분류하고 싶다면, 각 문서에 H/M/N Label이 붙어 있는 Dataset을 준비하고 BERT 같은 모델을 학습할 수 있습니다. 학습이 끝난 모델은 새로운 문서를 입력받아 H/M/N 중 하나를 예측하는 Classifier가 됩니다.
그런데 이번에는 같은 문서를 Display / Smart Window / Antenna / OCA로 분류해야 한다고 생각해보겠습니다. 기존 모델이 학습한 H/M/N이라는 Label과 전혀 다른 문제이기 때문에 새로운 Label에 맞는 Dataset을 준비하고 다시 학습하거나 Fine-tuning하는 것이 일반적인 접근입니다.
전통적인 Task-specific Classifier
Training : Patent Text → High / Medium / Noise
Inference : 새로운 Patent Text → High / Medium / Noise
즉 어떤 Task를 수행하고 어떤 Label을 출력할지가 일반적으로 Training 단계에서 정해집니다.
Jev가 지향하는 것은 이보다 범용적인 Decision Model입니다. 개발자가 Inference 시점에 State와 Question, 판단 기준 또는 가능한 선택지를 정의하고, 같은 Jev Model에 서로 다른 종류의 판단을 요청할 수 있습니다. 예를 들어 한 요청에서는 문서의 내용을 State로 넣고 "이 문서는 어떤 분야에 해당하는가?"라고 질문하면서 Smart Window / Display / Antenna / OCA를 선택지로 줄 수 있습니다. 다음 요청에서는 이메일 내용을 State로 넣고 "이 이메일의 긴급도는 어느 정도인가?"라고 질문하면서 Low / Medium / High / Critical을 사용할 수 있습니다.
즉 Jev에서는 특정 Application의 Label Space가 Model Training 단계에 하나로 고정되어 있는 것이 아니라, Application이 Runtime에 필요한 판단 문제를 정의할 수 있습니다. 이 점이 전통적인 Task-specific Classifier와 비교했을 때 중요한 차이입니다.
그렇다고 "Runtime에 선택지를 줄 수 있다"는 것 자체가 완전히 새로운 것은 아닙니다. 사실 지금의 LLM도 이미 비슷한 일을 할 수 있습니다. 예를 들어 GPT 같은 LLM에게 다음과 같이 요청할 수 있습니다.
다음 고객 문의를 분류해주세요.
billing
technical
refund
위 세 가지 중 하나를 선택해서 JSON으로 출력해주세요.
Structured Output을 지원하는 LLM API라면 JSON Schema까지 지정할 수 있기 때문에 결과만 놓고 보면 Jev와 상당히 비슷해 보입니다. 새로운 Task마다 Model을 다시 학습하지 않아도 자연어로 판단 기준과 선택지를 설명할 수 있다는 점도 비슷합니다.
그래서 Jev의 실제 비교 대상은 전통적인 BERT Classifier 뿐만이 아니라 LLM + Structured Output도 보는 것이 더 적절합니다.
그러나, Jev와 LLM은 크게 두 방식의 차이가 나타납니다. GPT와 같은 Generative LLM은 기본적으로 다음 Token을 예측하는 과정을 반복하면서 Output을 생성합니다. 우리가 원하는 최종 결과가 단순히 technical이라는 하나의 Decision이라고 해도 내부적으로는 {, "category", :, "technical", }과 같은 Output Sequence를 Autoregressive하게 생성하는 방식입니다.
Structured Output은 이렇게 생성되는 결과가 우리가 지정한 Schema를 따르도록 만들 수 있지만, 기본적으로 Generative Model을 이용해서 Decision을 표현하고 있는 것입니다.
Jev는 이 부분을 다르게 접근합니다. TypeSafe가 Jev를 설명할 때 사용하는 표현은 "unstructured state in, typed probabilistic decisions out"입니다. 비정형적인 State를 입력받아 문장을 만드는 것이 아니라, Software가 바로 사용할 수 있는 Typed Probabilistic Decision을 반환하는 것을 Model의 역할로 정의합니다.
| 구분 | LLM + Structured Output | Jev |
| 기본 문제 | Language Generation | Decision |
| 입력 | Prompt / Context / Schema | State / Question / Decision Type |
| 결과 | Schema에 맞춰 생성된 Output | Typed Probabilistic Decision |
| Task 범위 | Runtime에 자연어로 정의 가능 | Runtime에 판단 문제를 정의 가능 |
| 주요 활용 | 생성, 추론, 판단 등 범용 | 선택, 평가, 분류, Routing 등 Decision |
그렇다면 Jev의 고유한 특징은 "확률을 반환한다"는 것일까요? 이것도 아닙니다. 기존 Classifier 역시 오래전부터 확률 형태의 값을 반환해왔습니다. 예를 들어 Sentiment Classifier가 Positive 0.87, Neutral 0.09, Negative 0.04와 같은 값을 출력하는 것은 전혀 새로운 방식이 아닙니다. Reranker 역시 후보별 Score를 계산합니다. 그래서 Jev를 "확률로 판단하는 새로운 AI"라고 설명하는 것은 썩 정확하지 않습니다. 오히려 Jev가 만들려고 하는 차이는 범용적인 자연어 Task 이해, Runtime에 정의되는 Decision Space, Typed Output, Probability Calibration, 그리고 이를 Software에서 직접 사용할 수 있도록 만든 API의 조합에 있지 않을까 생각됩니다.
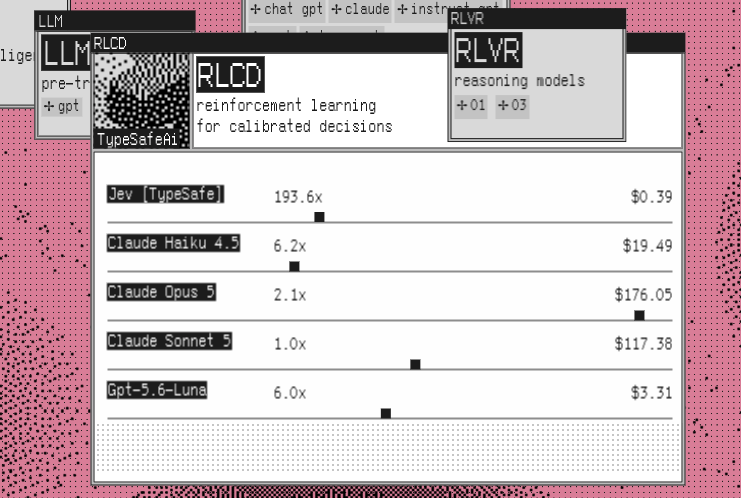
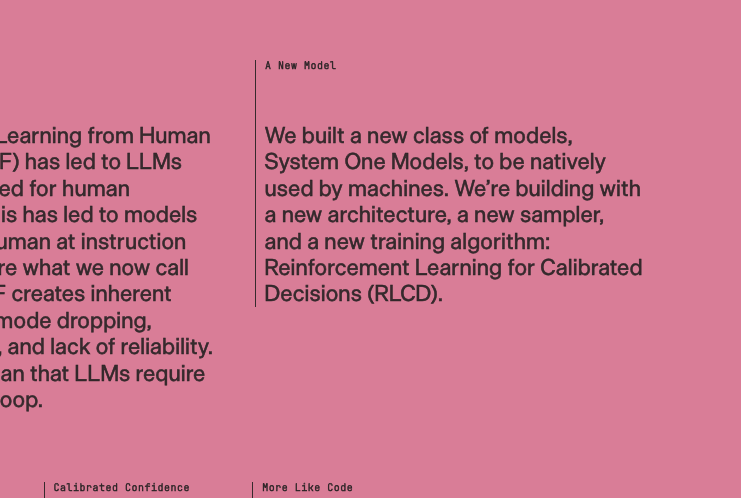
TypeSafe는 이 모델을 학습하기 위해 RLCD(Reinforcement Learning for Calibrated Decisions)라는 Training Method를 사용했다고 설명합니다. 여기에서 중요한 단어가 Calibrated입니다. 단순히 정답을 고르는 것뿐 아니라 Model이 반환하는 Probability가 실제 판단의 불확실성을 유용하게 표현하도록 만드는 것을 목표로 한다는 것입니다.
예를 들어 어떤 판단에 Model이 반복적으로 90% 수준의 확률을 준다면 실제로도 그 정도 수준의 성공률을 보이는 것이 이상적인 Calibration입니다. 그래야 Software에서 "확률이 충분히 높으면 자동 실행하고, 애매하면 추가 검증하거나 사람에게 넘긴다"와 같은 Policy를 만들 수 있기 때문입니다.
Generative LLM
Context → Language Generation
Task-specific Classifier
Input → Training 단계에서 정해진 Label
Jev
State + Question + Runtime에 정의된 Decision → Typed Probabilistic Decision
전통적인 Classifier가 가진 Decision-oriented Output과 LLM이 가진 자연어 기반의 Task Generality 사이를 연결하려는 것입니다. 새로운 Task마다 전용 Classifier를 만드는 대신 하나의 Decision Model을 Software Primitive처럼 반복해서 사용하는 방향입니다.
그리고 검색 Reranker와 비교하면 Jev의 성격이 더 잘 보이는데요. Reranker는 이미 후보들을 평가해서 순위를 만드는 Discriminative Model입니다. 예를 들어 2026년 공개된 jina-reranker-v3.5는 0.6B Parameter의 Listwise Reranker로, Query와 여러 문서를 함께 처리한 뒤 문서별 표현을 이용해 Relevance Score를 계산합니다. 답변 문장을 생성하지 않고 후보를 평가한다는 점에서는 Jev와 외형이 꽤 비슷합니다. 검색 시스템을 생각하면 구조를 이해하기 쉽습니다. Reranker에게는 Query와 여러 Candidate Document가 들어가고, Model은 "이 Query에 어떤 Document가 더 관련 있는가?"를 판단합니다. 이때 Document 대신 실행 가능한 Action을 넣으면 겉으로는 Decision Model과 비슷한 Interface를 만들 수도 있습니다.
하지만 후보별 Score를 계산할 수 있다는 것과, 그 Score가 우리가 원하는 판단 기준을 제대로 반영한다는 것은 전혀 다른 문제입니다. 검색 Reranker는 기본적으로 Retrieval Relevance를 잘 판단하도록 학습됩니다. "이 문서가 Query와 얼마나 관련 있는가?"를 판단하도록 학습된 Weight에 Action A와 Action B를 넣는다고 해서 갑자기 "현재 상황에서 어떤 행동이 더 적절한가?"를 잘 판단하게 되는 것은 아닙니다.
Jev의 차별점을 "문장을 생성하지 않는다"거나 "확률을 반환한다"는 한 가지 특징에서 찾기보다는, LLM처럼 Runtime에 다양한 문제를 정의할 수 있으면서도 결과를 Open-ended Generation이 아니라 Software가 바로 사용할 수 있는 Decision으로 제한하고, 그 Decision의 Probability까지 활용하려는 모델이라고 보는 것이 더 맞을지 않을까 생각합니다.
[3]. Jev는 어떻게 판단을 표현할까? Choice, Score, Noul
Jev를 실제로 사용할 때 중요한 것은 자유로운 Text가 아니라 어떤 형태의 Decision이 필요한지 정의하는 것입니다. 현재 Jev의 대표적인 Question Type은 Choice, Score, Noul입니다.
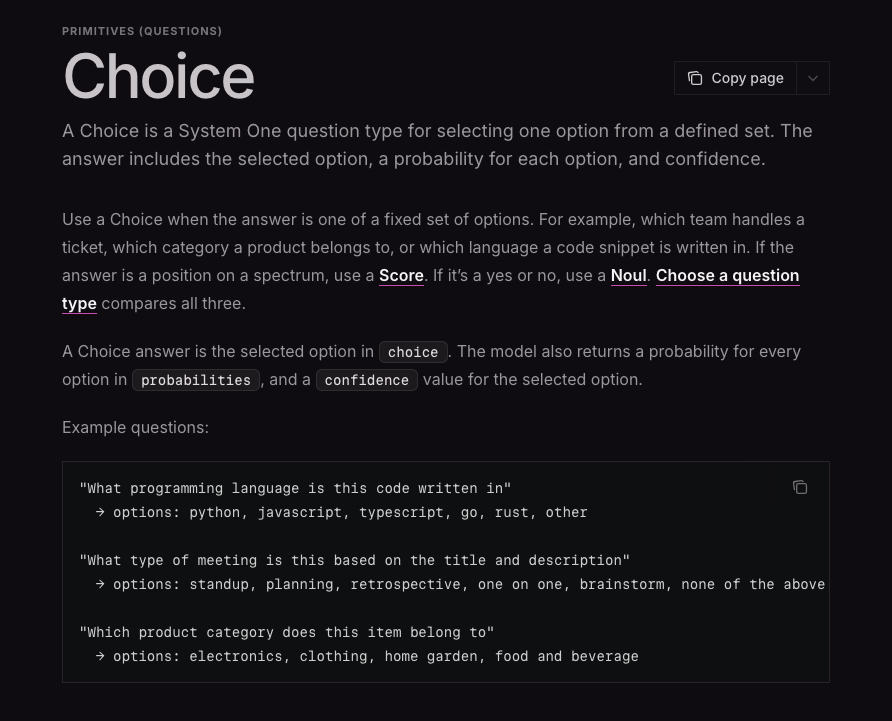
Choice는 여러 후보 가운데 하나를 선택하는 문제에 적합합니다. 예를 들어 현재 고객 요청을 Billing Agent, Technical Agent, Human Review 중 어디로 보낼 것인지 결정할 수 있습니다. 중요한 점은 단순히 선택된 Label만 받는 것이 아니라 후보에 대한 확률 정보도 함께 사용할 수 있다는 것입니다.
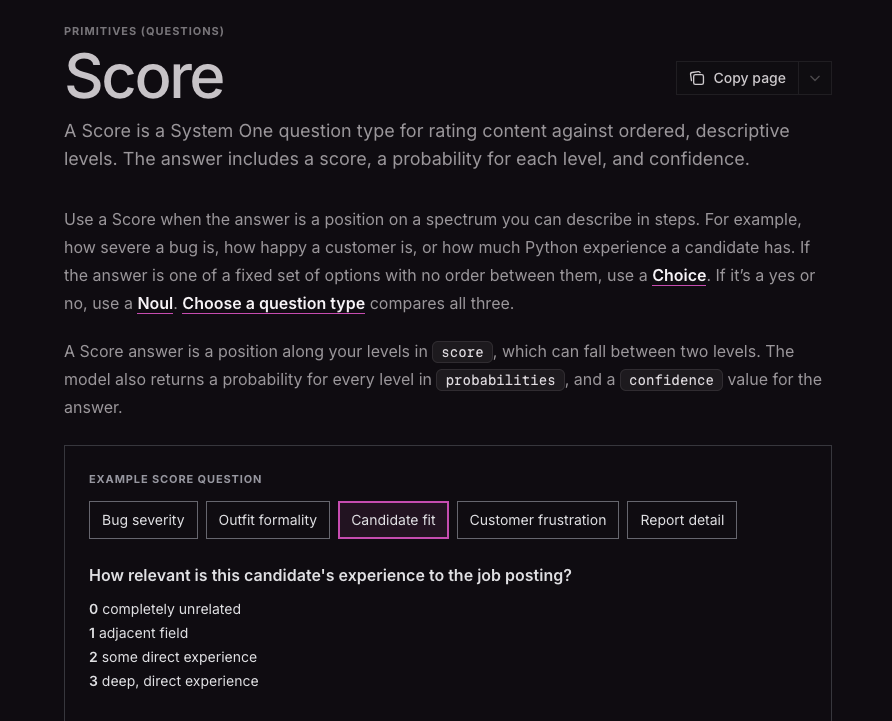
Score는 순서가 있는 평가 기준을 정의하고 그 기준에 따라 State를 평가하는 방식입니다. 예를 들어 문서 품질을 0~3으로 정의하고, 0은 무관함, 1은 주제만 관련됨, 2는 답이 있지만 불완전함, 3은 질문에 직접적이고 정확하게 답함과 같이 Rubric을 줄 수 있습니다. 각 Grade의 확률을 이용하면 Expected Score를 계산해 Ranking이나 Threshold에 사용할 수 있습니다.
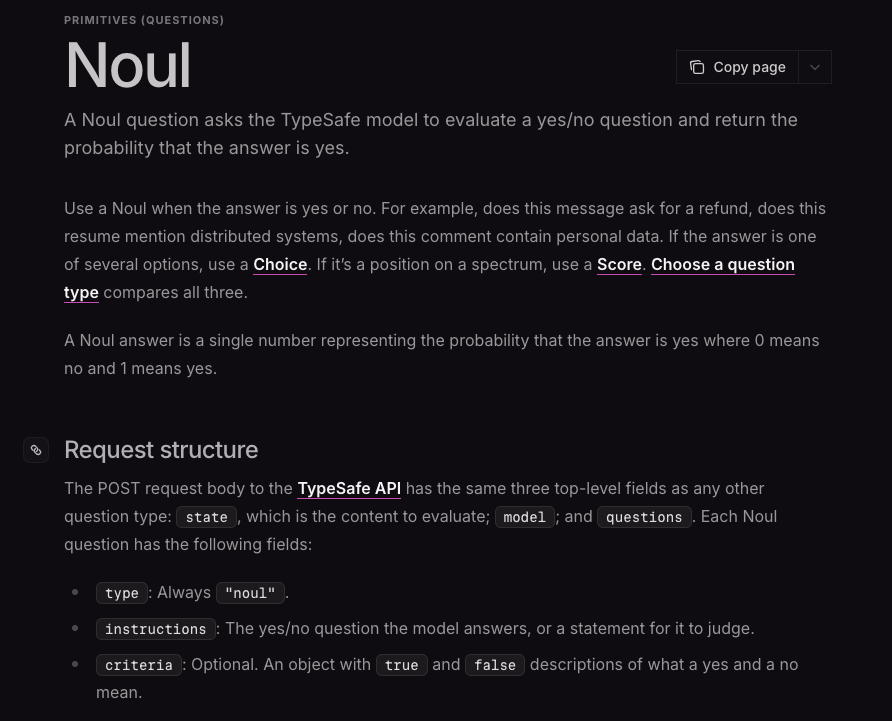
Noul은 Yes / No 형태의 명제에 대해 P(yes)를 반환하는 방식입니다. "이 요청은 Human Review가 필요한가?", "이 문서가 질문에 답하고 있는가?"처럼 Boolean Decision에 가까운 문제에 사용할 수 있습니다.
여기서 Choice와 Score의 차이는 실제 시스템을 설계할 때 꽤 중요합니다. Choice는 후보 가운데 무엇이 상대적으로 가장 좋은가를 묻는 데 적합하지만, Score는 각 후보가 절대적인 기준에서 어느 수준인가를 평가하는 데 더 적합합니다. 후보가 전부 좋지 않은 상황에서 "가장 좋은 후보"가 있다는 것과 "실제로 사용해도 충분히 좋은 후보"가 있다는 것은 다른 이야기입니다.
예를 들어 10개의 Tool 중 하나를 Choice로 고르면 어떤 Tool에는 가장 높은 확률이 주어집니다. 하지만 그것만으로 그 Tool이 현재 요청을 성공적으로 처리할 가능성이 높다는 뜻은 아닙니다. Agent에서 자동 실행 여부까지 결정하려면 상대적인 선택과 절대적인 적합성을 구분해서 설계해야 합니다.
[4]. Jev는 정말 LLM보다 100배 빠르고 저렴할까?
TypeSafe 공식 홈페이지에서 가장 눈에 띄는 숫자는 193.6배 빠르고, 444.6배 저렴하다는 주장입니다. 현재 공개 가격은 Input 10억 Token당 42달러, 즉 100만 Input Token당 0.042달러이며 Output Token은 별도 과금하지 않습니다. TypeSafe는 Jev의 End-to-end Response Time을 대략 70~500ms 범위로 소개하고 있습니다.
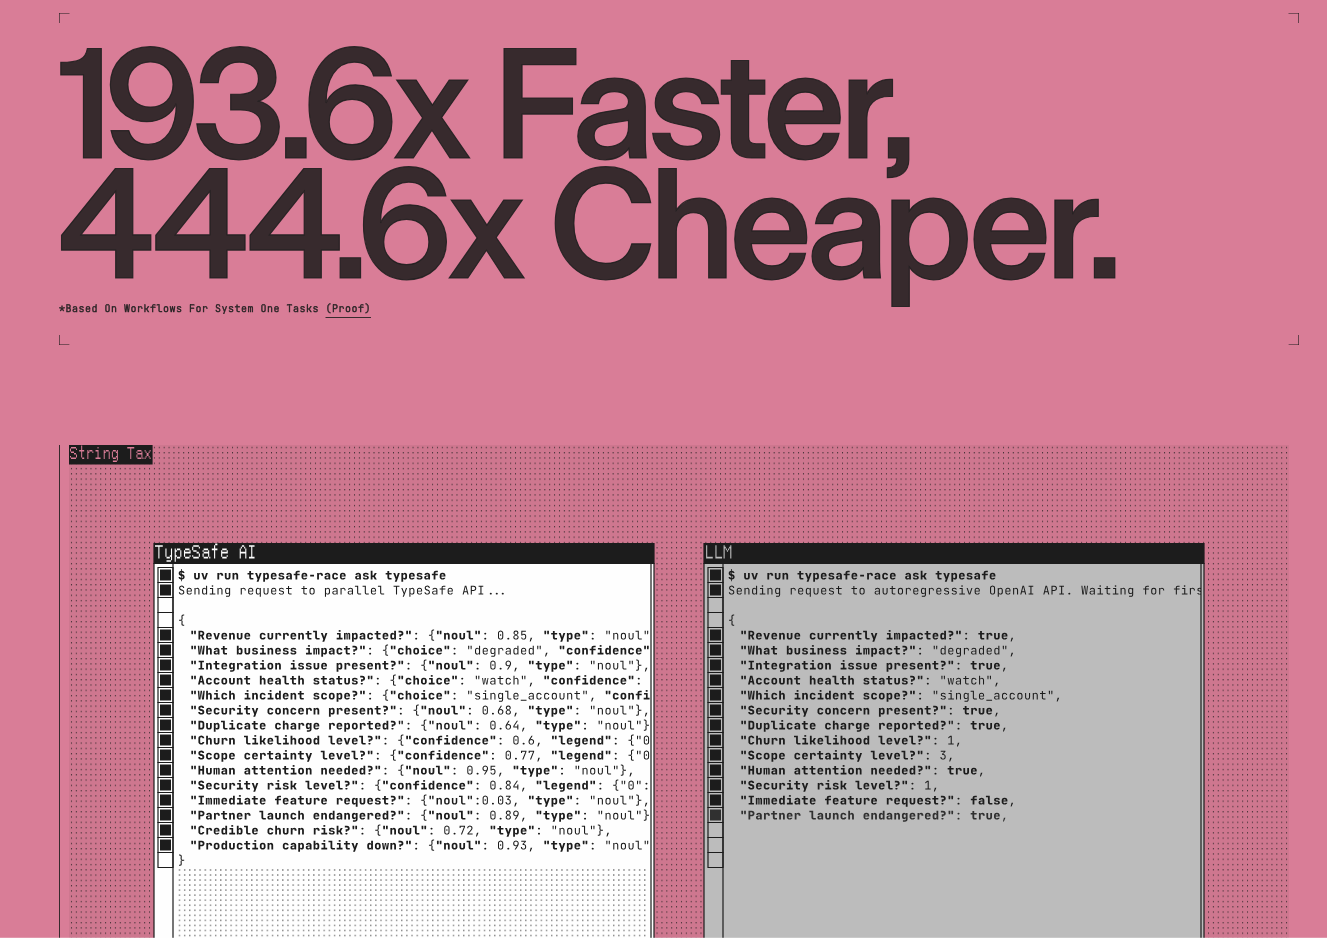
구조적인 이유는 이해하기 어렵지 않습니다. 일반적인 Generative LLM은 답변을 Token 단위로 순차 생성해야 합니다. 반면 Jev가 필요한 것은 미리 정의된 Decision이고, TypeSafe 설명상 여러 Question의 Output을 병렬적으로 처리합니다. 특히 같은 State에 대해 "어느 Agent로 보낼 것인가?", "Human Review가 필요한가?", "위험도는 어느 정도인가?"처럼 여러 판단을 반복해야 하는 Workflow에서는 Generation을 반복하는 것보다 훨씬 유리할 가능성이 있습니다.
[5]. Jev Engineering은 무엇인가?
Jev 공개 직후 커뮤니티에서 등장한 표현으로, Jev 같은 Decision Model을 Agent와 Software Workflow 안에서 어떻게 배치할 것인지 설명하는 Engineering Pattern입니다.
LLM은 생성하고(Write / Reason), Jev는 판단하고(Decide / Score / Route), Code는 실행한다(Act / Enforce).
예를 들어 Research Agent를 만든다고 생각해보겠습니다. 검색 결과를 읽고 내용을 요약하거나 보고서 문장을 작성하는 일은 LLM이 잘합니다. 하지만 "이 자료를 최종 보고서에 사용할 것인가?", "추가 검색이 필요한가?", "어느 Agent가 다음 작업을 해야 하는가?", "결과 품질이 기준을 넘었는가?"는 생성보다 Decision에 가까운 문제입니다. Jev Engineering에서는 이런 지점을 별도의 Decision Layer로 분리합니다.
그리고 "Confidence가 0.8 미만이면 Human Review", "최대 검색 횟수는 10회", "승인 전에는 외부 전송 금지"처럼 답이 명확한 규칙은 AI에게 맡기지 않고 일반 Code가 담당합니다.
| 역할 | 담당 | 예시 |
| 생성 / 복잡한 추론 | LLM | 보고서 작성, 요약, 코드 생성, 계획 수립 |
| 판단 / 평가 / 선택 | Jev | Routing, Relevance, Risk Score, 승인 여부 |
| 확정 규칙 / 실행 | Code | Threshold, 횟수 제한, 권한 검사, 실제 Tool 실행 |
Jev가 나오고나서 지금까지 Agent에서 LLM에게 너무 많은 종류의 일을 맡겨왔던 것을 분리할 수 있게 되었습니다. LLM이 계획을 만들고, Tool을 고르고, 결과를 평가하고, 다음 Agent를 고르고, 종료 여부를 판단하고, 마지막 답변까지 작성하는 구조가 흔합니다. 하지만 이 작업들을 자세히 보면 Generation Problem과 Decision Problem, Deterministic Rule이 섞여 있습니다.
Jev Engineering은 이들을 다시 분리합니다. 모든 것을 Jev로 바꾸자는 이야기도 아니고 LLM을 없애자는 이야기도 아닙니다. 오히려 LLM은 Open-ended Generation과 Reasoning에 집중하고, 반복적으로 발생하는 좁은 판단은 Decision Model에 맡기고, 반드시 지켜야 하는 규칙과 Side Effect는 Code가 통제하도록 역할을 나누는 것입니다.
Jev에서 개인적으로 중요하게 보는 부분
지금까지 Generative AI가 빠르게 발전하면서 자연어로 표현할 수 있는 문제를 일단 LLM에게 던지는 방식이 굉장히 강력했습니다. Classification도 LLM, Routing도 LLM, Evaluation도 LLM, LLM-as-a-Judge도 LLM이었습니다. Structured Output과 Function Calling이 발전하면서 이 방식은 더 편리해졌습니다.
하지만 실제 Production Workflow에서는 모든 단계가 긴 문장을 생성할 필요가 없습니다. "A와 B 중 무엇을 선택할 것인가?", "이 결과가 기준을 통과했는가?", "어느 Tool을 호출할 것인가?", "사람에게 넘겨야 하는가?"처럼 결과가 몇 개의 Decision으로 끝나는 작업이 굉장히 많습니다.
"이 단계에서 정말 Text Generation이 필요한가?"
필요하다면 LLM을 사용하면 됩니다. 필요한 것이 후보 선택이나 점수, Boolean Judgment라면 Decision Model이 더 적합할 수 있습니다. 결과가 반드시 지켜야 하는 명확한 Rule이라면 AI가 아니라 Code로 처리하는 편이 낫습니다.
Jev가 장기적으로 새로운 Model Category로 자리 잡을지는 아직 판단하기 이르다고 생각합니다. 공개된 지 며칠밖에 되지 않았고, 요즘 뭐 새로운 것들이 엄청 나오니까요 ㅎㅎ
다만 Jev가 던진 문제 자체는 꽤 명확합니다. "Generative AI가 잘하는 것과 Software가 실제로 필요로 하는 Decision은 항상 같은 문제가 아니다."라는 것이죠. 앞으로 Agent가 복잡해질수록 생성, 판단, 실행을 어떤 Model과 Code에 나눠 맡길 것인지가 Agent Architecture에서 더 중요한 설계 문제가 될 가능성이 있습니다.
참고 자료
- TypeSafe AI - Introducing System One Models & Jev (2026.09.15) - 공식 글
- TypeSafe AI - Official Website / Jev - 공식 홈페이지
- TypeSafe AI - Workflow Evals - 공식 평가 페이지
- TypeSafe AI JavaScript/TypeScript SDK - 공식 GitHub
- jina-reranker-v3.5: An Efficient Listwise Reranker with Hybrid Attention and Self-Distillation - arXiv
- Jina AI - jina-reranker-v3.5 - Hugging Face / Jina AI
- Jev Engineering 관련 공개 Guide - Jev 공개 직후 Community에서 등장한 용어의 기원과 공통 Pattern을 확인하는 보조 자료로 사용
부족한 글이지만 긴 글 읽어주셔서 감사합니다.
혹시라도 저에게 연락을 주시고 싶으시다면,
- Linkedin: https://www.linkedin.com/in/lsjsj92/
- Email: lsjsj92@naver.com
- 블로그 댓글 또는 방명록
으로 부탁드립니다~
'인공지능(AI) > AI 일반' 카테고리의 다른 글
| Claude Code rc(remote control)란? 클로드 코드 원격 제어 사용법 (0) | 2026.09.15 |
|---|---|
| GPT-6 출시! 주요 특징 정리 - 더 똑똑한 모델을 넘어 일을 끝내는 Agent로 (0) | 2026.09.06 |
| 클로드 코드(Claude code)로만 만들어 본, 프로젝트 관리 서비스 개발기 (0) | 2026.08.01 |
| Claude Opus 5 공개 - 성능, 가격, 프롬프트 가이드 정리(Claude code) (0) | 2026.07.28 |
| 앤트로픽 Claude Fable 5와 Mythos 5, 왜 출시 사흘 만에 차단됐을까 (2) | 2026.06.20 |


