포스팅 개요
2026년 8월 Netflix가 GenRec: An LLM-Backed Recommendation Ranker at Netflix라는 논문을 공개했습니다. 제목만 보면 요즘 많이 연구되고 있는 Generative Recommendation, 즉 LLM이 사용자의 이력을 보고 다음 콘텐츠를 직접 생성하는 방식처럼 보입니다. 그런데 실제 구조를 보면 조금 다릅니다. GenRec은 Decoder-only LLM을 Backbone으로 사용하지만, 실제 추천 시점에는 영화나 시리즈의 제목을 Token 단위로 생성하지 않습니다. 사용자의 행동 이력과 현재 Context를 LLM이 이해하고 하나의 Representation으로 만든 뒤, 마지막의 Catalog-aware Ranking Head가 Netflix Catalog의 콘텐츠마다 Score를 계산해 순위를 만듭니다.
그래서 이 논문에서 개인적으로 가장 흥미롭게 본 부분은 "Netflix도 추천 시스템에 LLM을 쓰기 시작했다"는 것이 아닙니다. LLM을 Recommendation에 활용하는 연구는 이미 지난 몇 년 동안 상당히 많이 나왔습니다. 더 중요한 것은 Netflix가 오랫동안 운영해 온 Feature Engineering 중심의 추천 시스템을 Foundation Model + Context Engineering + Post-training 중심의 구조로 바꾸기 시작했고, 그러면서도 LLM의 Autoregressive Generation을 그대로 가져오지 않았다는 점입니다.
오히려 GenRec을 자세히 보면 기존 Recommendation과 최근 LLM 연구가 절충되는 지점이 보입니다. LLM 시대에 얻은 범용적인 Semantic Understanding과 Transfer Learning은 적극적으로 활용하지만, 최종 문제가 Ranking이라면 Text를 생성하지 않고 다시 Ranking Model처럼 동작합니다. 최근 공개된 Jev 같은 Decision Model이 "Software가 필요한 것은 항상 문자열이 아니라 Decision일 수 있다"는 문제를 제기한 것과도 묘하게 맞닿아 있습니다. 물론 GenRec과 Jev는 전혀 다른 Model이지만, 범용적인 Intelligence와 Task에 맞는 Output Interface를 분리하기 시작했다는 최근 AI Engineering의 흐름을 이해하는 데 좋은 사례라고 생각합니다.
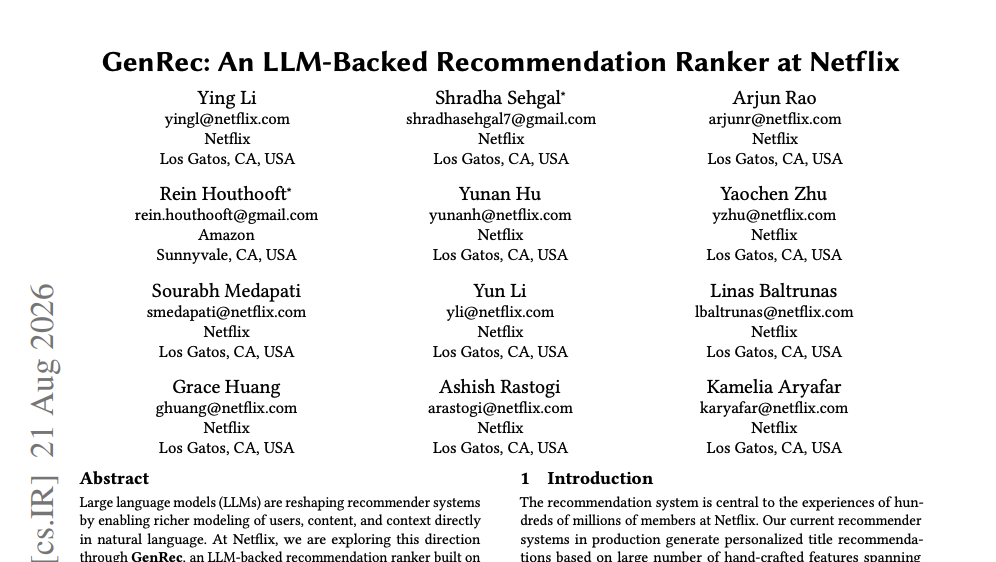
핵심부터 정리하면, GenRec은 "LLM에게 추천 콘텐츠를 생성하게 하는 모델"이 아닙니다.
사용자 이력과 Context를 LLM이 이해하도록 만들고, 그 Representation을 Netflix Catalog에 특화된 Ranking Head와 연결합니다. 즉 LLM의 Semantic Intelligence는 사용하지만 Ranking은 Ranking답게 처리합니다. 그리고 Netflix는 이 구조를 통해 추천 시스템의 개발 중심을 Feature Engineering에서 Context Engineering으로, Task별 전용 Architecture에서 Shared Foundation Backbone으로 옮기려고 합니다.
포스팅 본문
[1]. Netflix 추천 시스템은 왜 다시 Foundation Model과 LLM으로 가고 있을까?
Netflix는 Recommendation System의 역사가 긴 회사입니다. Netflix Prize가 시작된 2000년대 중반에는 사용자가 콘텐츠에 몇 점을 줄지를 정확하게 예측하는 Rating Prediction이 대표적인 문제였습니다. Matrix Factorization 같은 Collaborative Filtering 기법이 이 시기를 대표합니다. 하지만 실제 서비스에서 중요한 것은 Rating 자체를 맞히는 것이 아니라 수많은 콘텐츠 중 지금 이 회원에게 무엇을 먼저 보여줄 것인지였습니다. 그래서 Recommendation의 중심은 점차 Rating Prediction에서 Personalized Ranking으로 이동했습니다.
2015년 Netflix가 공개한 Learning a Personalized Homepage를 보면 이 변화가 더 잘 보입니다. 콘텐츠 하나하나의 순위만 잘 맞히는 것으로는 충분하지 않았습니다. Netflix Home 전체에는 여러 Row가 존재하고, 어떤 Row를 위에 배치할지, Row 안에서는 어떤 콘텐츠를 앞쪽에 보여줄지, 서로 비슷한 콘텐츠만 반복되지 않도록 Diversity를 어떻게 확보할지까지 고려해야 했습니다. Netflix는 당시 자신들의 Personalization이 Rating Prediction → Video Ranking → Page Generation으로 발전했다고 표현했습니다.
이후 연구도 같은 방향으로 확장됩니다. 단순 Click이나 Play만 극대화하는 대신, 장기적인 Member Satisfaction을 Reward로 모델링하고, Contextual Bandit과 Reinforcement Learning으로 Exploration을 다루고, Session 안에서 갑자기 바뀌는 Intent를 반영하고, A/B Test와 Causal Inference를 이용해 추천이 실제로 사용자 행동에 어떤 영향을 주었는지 평가했습니다. 2023년 발표한 Reward Innovation for Long-Term Member Satisfaction에서도 Netflix는 Engagement가 풍부하고 빠르게 관측할 수 있다는 장점이 있지만 장기적인 회원 만족도의 완벽한 Proxy는 아니라고 설명했습니다.
그런데 이런 연구가 오랫동안 쌓이면서 다른 문제가 생깁니다. Netflix에는 Continue Watching, Today’s Top Picks, Search, Artwork Personalization처럼 목적이 서로 다른 수많은 Personalization Model이 있고, 영화와 시리즈를 넘어 Games, Live, Podcast 등 콘텐츠 종류도 계속 늘어났습니다. 기존 방식에서는 새로운 Recommendation Surface나 콘텐츠가 추가될 때마다 새로운 Feature를 만들고, Model Architecture를 설계하고, Pipeline과 Infrastructure를 수정해야 했습니다. 각각의 Model이 비슷한 User Interaction Data를 사용하면서도 독립적으로 학습되기 때문에 한 Model에서 발견한 개선 방법을 다른 Model로 옮기는 것도 쉽지 않았습니다.
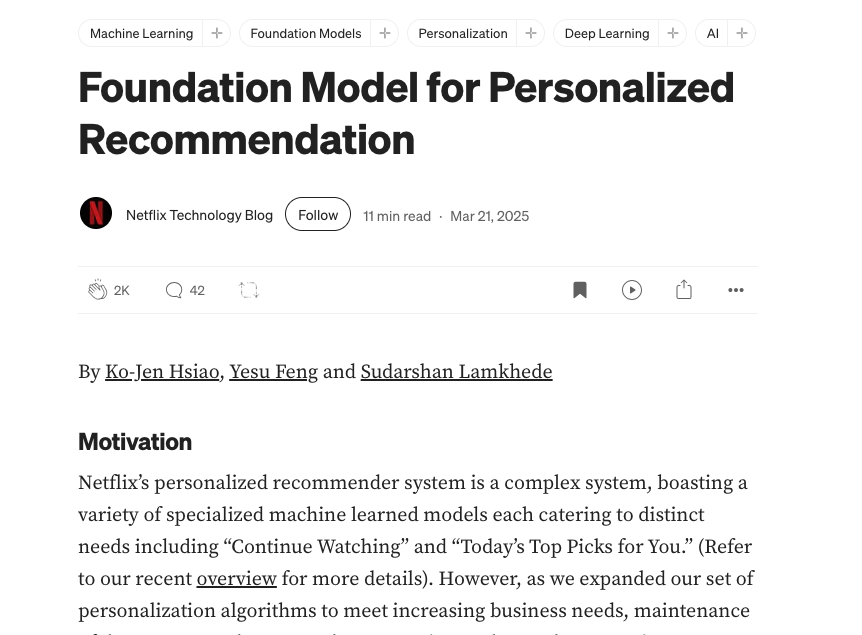
이 문제를 해결하기 위해 Netflix가 2025년부터 본격적으로 공개하기 시작한 것이 Personalization Foundation Model입니다. 여러 Recommendation Model이 사용자의 Preference를 각각 처음부터 다시 학습하는 대신, Netflix 전체의 대규모 Interaction History와 Content Data에서 먼저 강력한 공통 Representation을 학습하고 이를 여러 Downstream Application에서 재사용하자는 것입니다. NLP에서 Task마다 개별 Model을 만들던 구조가 BERT나 GPT 같은 Pre-trained Foundation Model 중심으로 바뀐 것과 비슷한 변화입니다.
GenRec은 이 흐름에서 갑자기 등장한 별개의 연구가 아닙니다. 오히려 Netflix가 지난 몇 년 동안 진행해 온 Foundation Model, Long-term Reward, Session Intent, Generative Recommendation Post-training, LLM Serving 연구가 Production Ranking Model이라는 하나의 문제에서 합쳐진 결과에 가깝습니다.
[2]. GenRec 구조: LLM이 추천을 해주는 것인가, 아니면 Feature를 만들어주는 것인가?
GenRec 구조를 보면 처음에는 "결국 LLM으로 User Embedding 하나 만든 다음 기존 Recommendation Model에 Feature로 넣는 것 아닌가?"라는 생각이 들 수 있습니다. 아주 높은 수준에서 보면 어느 정도 맞는 말입니다. 모든 Neural Recommendation Model은 결국 Input을 받아 Representation을 만들고, 그 Representation으로 Item의 Score를 계산하기 때문입니다. 하지만 GenRec에서는 LLM이 외부에서 User Summary나 Embedding을 하나 생성해 주고 별도의 기존 Ranker가 사용하는 구조가 아닙니다.
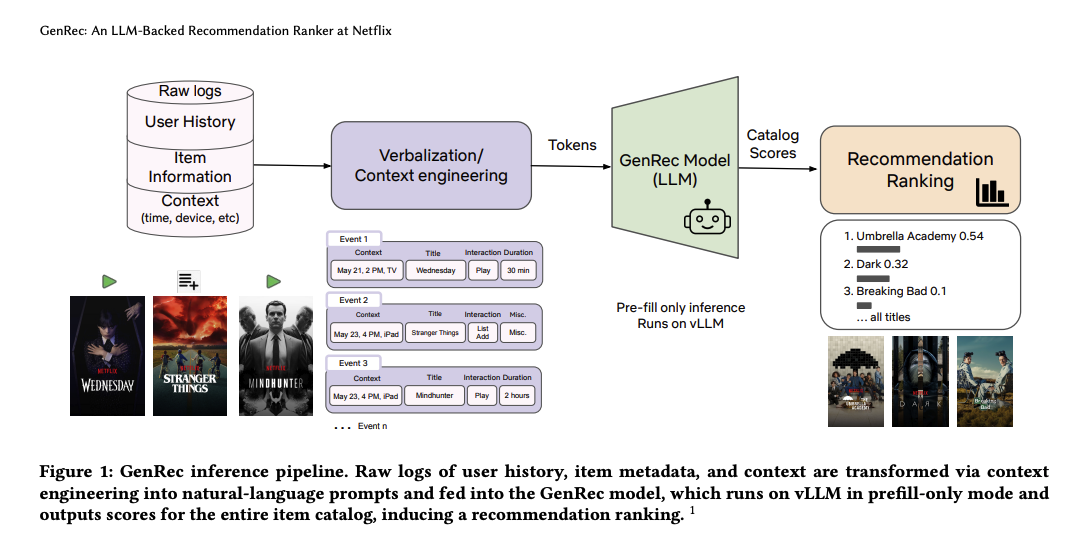
논문의 Figure 1이 전체 흐름을 잘 보여줍니다. 왼쪽에는 Raw Log 형태의 User History, Item Information, 현재 시간이나 Device 같은 Context가 있습니다. 이를 Verbalization / Context Engineering 단계에서 자연어나 가볍게 구조화된 Text로 변환한 뒤 GenRec LLM에 입력합니다. LLM은 이 입력 전체를 처리해 현재 사용자의 Preference와 상황을 압축한 Hidden Representation을 만들고, 마지막 Catalog-aware Ranking Head가 Netflix Catalog 전체 또는 Candidate Set의 Item에 Score를 부여합니다. 최종적으로 Score가 높은 Item 순으로 Recommendation Ranking이 만들어집니다.
기존 Recommendation Ranker
Raw Data → Feature Engineering → Hundreds / Thousands of Features → Recommendation-specific Model → Score
GenRec
Raw Interaction / Context → Verbalization & Context Engineering → LLM Backbone → User-Context Representation → Catalog-aware Ranking Head → Score
여기서 Ranking Head는 독립적으로 존재하는 별도의 Recommendation System이 아닙니다. LLM Backbone과 Ranking Head를 합친 전체 Model이 GenRec입니다. 논문에서는 LLM의 Weight, Ranking Head, 각 Item의 Embedding을 함께 학습한다고 설명합니다. 즉 general-purpose LLM을 Frozen 상태로 두고 Embedding만 받아 사용하는 구조와도 다릅니다. Recommendation Ranking Loss가 LLM Backbone까지 영향을 주기 때문에 LLM 자체가 "어떤 Representation이 실제 추천에 유용한가"를 학습합니다.
Catalog-aware라는 표현도 중요합니다. 일반 LLM에게 "이 사용자에게 볼 만한 작품을 추천해 줘"라고 하면 Model은 작품명을 문자열로 생성합니다. 이 경우 Netflix에 없는 작품을 추천할 수도 있고, Catalog 전체에 대해 일관된 Ranking Score를 계산하기도 어렵습니다. GenRec의 Output Space는 처음부터 Netflix Catalog로 제한되어 있습니다. LLM이 임의의 제목을 만들어내는 것이 아니라 학습된 Item Embedding과 User-Context Representation을 Ranking Head가 결합해 Score를 계산합니다. 따라서 Out-of-catalog Recommendation 문제를 Architecture 수준에서 막을 수 있습니다.
이 점에서 Netflix GenRec은 최근의 Generative Retrieval 계열과도 차이가 있습니다. TIGER나 Google PLUM, Spotify GLIDE, Kuaishou OneRec 계열처럼 Item을 Semantic ID Token으로 표현하고 다음 Item Token을 Autoregressive하게 생성하는 방법들이 활발히 연구되고 있습니다. 이런 방식은 Retrieval과 Ranking을 Generation Problem으로 통합한다는 장점이 있지만, Candidate가 커질수록 Beam Search나 Sequential Decoding 비용이 부담될 수 있습니다. Netflix는 Pre-trained LLM의 Semantic Capability는 사용하면서도 최종 단계에서는 기존 Ranking System이 가진 효율적인 Scoring 방식을 남기는 쪽을 선택했습니다.
[3]. Phase 1과 Phase 2는 무엇이 다른가? Foundation Model을 만들고 다시 Fine-tuning하는 이유
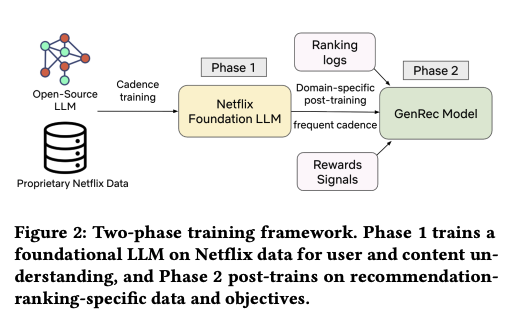
GenRec의 Figure 2에서는 Training을 Phase 1과 Phase 2로 나눕니다. 이 부분을 처음 보면 "LLM을 두 개 만드는 것인가?", "Foundation Model도 학습하고 Recommendation Model도 다시 학습하면 오히려 훨씬 비싼 것 아닌가?"라는 생각이 듭니다. Phase 1에서는 Open-source LLM을 Netflix의 Proprietary Data에 적응시켜 Netflix-aware Foundation LLM을 만듭니다. 여기서는 특정 Recommendation Ranking 하나를 잘하도록 만드는 것이 목적이 아닙니다. Content Understanding, Member Behavior에 대한 일반적인 이해, Personalization Capability, Language Capability와 Instruction Following처럼 여러 Application에서 재사용할 수 있는 비교적 범용적인 능력을 만드는 것이 목적입니다.
Phase 2에서는 이 Foundation LLM을 시작점으로 Recommendation Ranking에 필요한 Dataset, Label, Reward, Verbalization을 사용해 다시 Post-training합니다. 일반적인 표현으로는 Recommendation-specific Fine-tuning이라고 이해해도 크게 틀리지 않지만, Ranking Loss뿐 아니라 Language Modeling Objective와 여러 Reward Signal을 함께 사용하기 때문에 논문에서는 더 넓은 의미의 Post-training이라고 표현합니다. 이 단계를 거쳐 만들어지는 Model이 실제 GenRec Ranker입니다.
| 구분 | Phase 1 | Phase 2 |
| 역할 | Netflix Foundation LLM 구축 | Recommendation Ranker로 Post-training |
| 학습 중심 | User / Content Understanding, 범용 Personalization Capability | Ranking Quality, Recommendation Steering, Business Objective |
| Update | 상대적으로 낮은 빈도 | 상대적으로 높은 빈도 |
| 변화 대응 | 장기적인 User / Content Understanding | 새 콘텐츠, Popularity 변화, 최신 Member Interest |
| 비용 관점 | 비싸지만 여러 Application이 재사용할 수 있는 Base | 자주 갱신해야 하므로 Data / Compute Efficiency가 중요 |
여기서 중요한 것은 Recommendation Request마다 Phase 1 Model을 한 번 실행하고 Phase 2 Model을 다시 실행하는 구조가 아니라는 점입니다. Phase 1 → Phase 2는 Training Lineage입니다. Phase 1의 Checkpoint를 시작점으로 Phase 2 Post-training을 수행해 새로운 GenRec Checkpoint를 만들고, 실제 Serving에서는 GenRec을 사용합니다. 따라서 Model이 두 단계로 학습된다고 해서 Inference를 두 번 수행하는 것은 아닙니다.
그렇다고 Training Cost 문제가 사라지는 것은 아닐 것으로 생각됩니다. Foundation LLM을 만드는 Phase 1은 기존의 작은 Recommendation Model보다 훨씬 비쌀 가능성이 있고, Phase 2에서도 LLM Backbone까지 Jointly Update합니다. 아마 이 부분에서 경제성이나 ROI를 고려해야 하지 않을까 싶네요. 다만, Netflix가 기대하는 경제성은 "LLM 하나를 학습하는 비용 자체가 작다"가 아니라 비싼 Representation Learning을 Foundation Model에 모아 여러 Application이 공유하고, 자주 갱신해야 하는 Downstream 단계의 Marginal Cost를 낮춘다는 쪽에 가깝습니다. 실제로 Netflix가 Foundation Model의 Production Integration을 설명한 별도의 글에서는 Profile / Item Embedding을 사용하는 방법, Foundation Model 일부를 Downstream Model의 Subgraph로 사용하는 방법, Foundation Model 자체를 Application Objective에 Fine-tuning해서 사용하는 방법이라는 세 가지 형태를 운영한다고 소개했습니다. 즉 모든 Personalization Model을 한 번에 거대한 LLM 하나로 교체하는 전략이 아닐 것이라고 생각이 됩니다.
[4]. Feature Engineering에서 Context Engineering으로, 실제로 무엇이 달라지는가?
논문에서 반복해서 강조하는 표현 중 하나가 Feature Engineering → Context Engineering입니다. 이 표현만 보면 Feature를 없애고 자연어 Prompt로 대체했다는 정도로 오해하기 쉬운데, 조금 더 본질적인 변화가 있습니다.
기존 Recommendation System에서는 최근 7일 시청 횟수, 장르별 Watch Time, 완주율, 마지막 시청 콘텐츠와의 Similarity, 특정 Genre에 대한 Affinity처럼 유용할 것이라고 생각되는 Signal을 사람이 Feature로 정의하고 계산합니다. 새로운 Feature를 추가하려면 Data Pipeline부터 Serving까지 연결해야 하고, Feature끼리 어떤 Interaction을 학습시킬지도 Model Architecture에서 고민해야 합니다. GenRec은 보다 원천적인 User Interaction, Content Metadata, Time, Device, Surface 같은 Signal을 자연어 또는 가볍게 구조화된 Text로 표현하고, 그 관계를 LLM이 자신의 Semantic Space에서 학습하도록 합니다. Netflix는 수천억 건 규모의 Interaction Event를 하나의 User-Recommender Conversation처럼 변환합니다. User Message에는 현재 Context와 History, Task가 들어가고, Assistant Message에 해당하는 Ground Truth는 실제 사용자가 이후에 수행한 Play, Play Duration, Abandon, Thumb 같은 행동입니다.
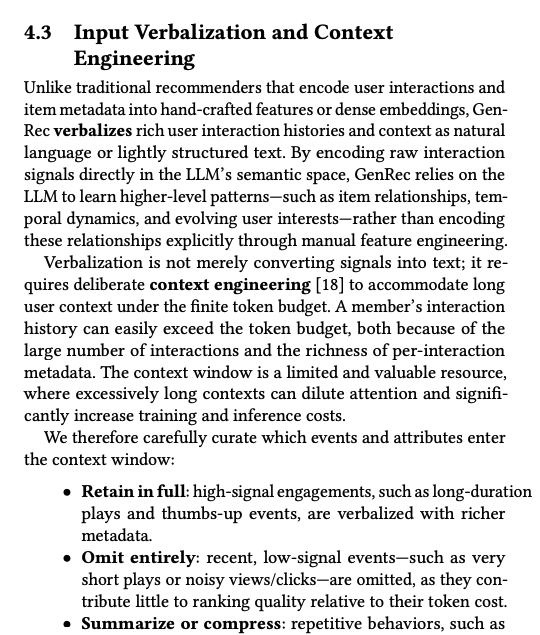
그렇다고 모든 History를 무작정 LLM에 넣는 것은 아닙니다. 오히려 이 지점에서 Context Engineering이 중요해집니다. 긴 시간 동안 시청했거나 Thumb-up처럼 Preference가 분명한 Interaction에는 더 많은 정보를 할당하고, 짧은 Play나 Noise에 가까운 Click은 제거합니다. Binge Watching처럼 같은 Pattern이 반복되는 History는 압축하고, Interaction Data가 부족한 새로운 콘텐츠나 Cold-start Item에는 Metadata를 조금 더 자세하게 제공합니다. 최근 History는 세밀하게 보여주는 반면 오래된 History는 요약하거나 생략합니다.
즉 Feature Engineering이 없어졌다기보다는 설계의 추상화 수준이 올라갔다고 보는 편이 더 정확할 것 같습니다. 예전에는 "최근 7일 Genre Watch Ratio라는 Feature를 만들자"였다면 이제는 "최근의 High-signal Interaction은 자세히 보여주고 오래된 반복 행동은 Preference Summary로 압축하자"라는 정보 표현 정책을 설계합니다. 논문은 이를 두고 Prompt가 새로운 Feature Vector가 된다고 표현합니다.
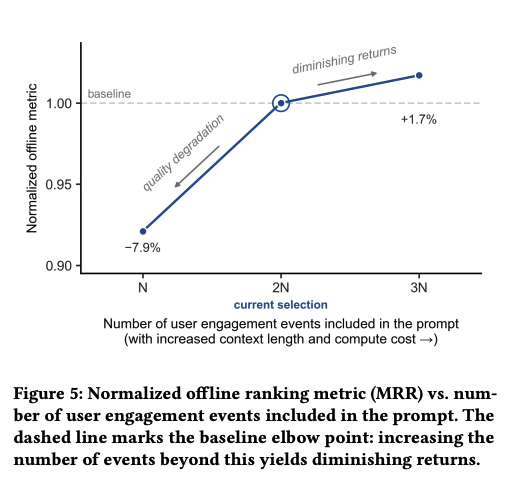
Context Length 실험은 이 변화가 단순한 표현상의 차이가 아니라 비용 문제와 직접 연결된다는 것을 보여줍니다. 논문의 Figure 5에서는 Prompt에 포함하는 User Engagement Event 수를 늘리면 처음에는 MRR이 올라가지만 일정 지점 이후부터 추가 History가 주는 이득이 급격하게 감소하는 Elbow Point가 나타납니다. Netflix는 이 지점을 찾은 뒤 Event Selection과 Compression, History Length 조절, 표현 단순화, Few-shot Example 제거 등을 적용합니다.
결과적으로 약 5,000 Token 수준이던 Context를 약 1,700 Token까지 줄였는데 Offline Ranking Quality의 하락은 거의 없었습니다. GenRec의 Serving Cost가 Context Length에 상당히 비례하기 때문에 추론 비용도 대략 기존의 3분의 1 수준까지 줄었다고 논문은 설명합니다.
[5]. LLM인데 왜 Token을 생성하지 않을까? Prefill-only Inference가 중요한 이유
GenRec을 처음 볼 때 가장 헷갈리는 부분이 이것입니다. GenRec의 Backbone은 분명 Decoder-only LLM입니다. Decoder-only LLM이라면 GPT처럼 다음 Token을 하나씩 Autoregressive하게 생성해야 하는 것 아닌가 생각할 수 있습니다. 하지만 Model Architecture가 Generative하다는 것과 실제 Application에서 반드시 Generation을 수행해야 한다는 것은 서로 다른 이야기입니다.
일반적인 LLM Inference는 크게 두 단계로 나눌 수 있습니다. 먼저 입력 Prompt 전체를 Model에 통과시키는 Prefill을 수행합니다. 이 과정에서 각 Token에 대한 Hidden State와 KV Cache가 만들어집니다. 이후 생성이 필요한 경우 이 정보를 이용해 다음 Token을 하나씩 Decode합니다. 긴 답변을 생성할수록 Decode가 반복됩니다.
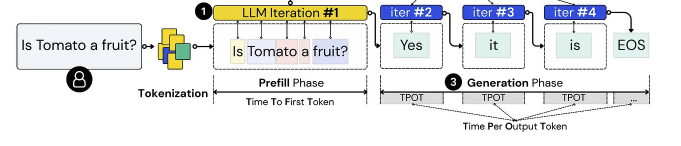
GenRec은 여기서 Prefill까지만 수행합니다. User History와 Context를 한 번 읽은 뒤 특정 Pooling Position의 Hidden State를 User-Context Representation으로 사용하고, 그 Representation을 Catalog-aware Ranking Head에 넘깁니다. 따라서 추천 콘텐츠의 제목을 하나씩 생성할 필요도 없고 Beam Search를 수행할 필요도 없습니다. 논문에서는 이를 Prefill-only Inference라고 부르며 Netflix의 자체 LLM Serving Stack과 vLLM 위에서 서비스합니다.
일반 Generative LLM
Context → Prefill → Token → Token → Token → ... → Text
GenRec
User / Item Context → Prefill → Hidden Representation → Ranking Head → Catalog Score
이 지점은 2026년 9월 공개되어 최근 화제가 되고 있는 TypeSafe의 Jev를 같이 놓고 보면 꽤 흥미롭습니다. TypeSafe가 Jev를 설명하면서 던지는 질문은 "Software가 필요한 것이 결국 Choice나 Score 같은 Decision인데 왜 굳이 문자열을 Autoregressive하게 생성해야 하는가?"에 가깝습니다.
GenRec 역시 Recommendation 영역에서 비슷한 질문에 이미 다른 방식으로 답하고 있습니다. LLM이 자연어와 Context를 잘 이해한다는 장점은 가져오되, 그렇다고 Recommendation이라는 문제를 굳이 Text Generation Problem으로 바꿀 필요는 없다는 것입니다. LLM은 Context를 이해하고 Representation을 만드는 데 사용하고, Ranking은 Ranking Head가 처리합니다.
Generative Model이라는 것과 Generative Inference를 사용한다는 것은 같은 말이 아닙니다.
최근 AI System을 보면 범용적인 Context Understanding은 Foundation Model에서 가져오되, 최종 Output은 Ranking, Choice, Score, Probability처럼 실제 Task에 맞는 형태로 다시 좁히는 흐름이 나타나고 있습니다. Netflix GenRec은 Recommendation에서 이 변화를 보여주는 좋은 사례입니다.
LLM이 등장한 뒤 Classification도 LLM, Routing도 LLM, Evaluation도 LLM-as-a-Judge, Ranking도 JSON Array Generation으로 바꾸는 경우가 많았습니다. 자연어만으로 새로운 Task를 정의할 수 있기 때문에 굉장히 편리했기 때문입니다. 그런데 Production 규모가 커지면서 다시 "이 단계에서 정말 Generation이 필요한가?"를 묻기 시작한 것입니다. 보고서를 쓰는 것은 Generation Problem이지만 1만 개 콘텐츠의 순서를 정하는 것은 Ranking Problem입니다. 5개의 Agent 중 하나를 선택하는 것은 Routing Problem이고, 결과가 기준을 넘었는지 판단하는 것은 Evaluation Problem입니다.
Netflix의 GenRec이 보여주는 방향은 LLM을 포기하고 전통적인 Model로 돌아간다는 의미가 아닙니다. 반대로 LLM 시대에 얻은 범용적인 Intelligence는 유지하면서, Production System의 Output Interface는 문제에 맞게 다시 전문화하는 쪽에 가깝게 변화한다는 생각입니다.
[6]. 추천을 잘하는 것과 오래 Netflix를 이용하게 만드는 것은 같은 문제가 아니다
GenRec이 단순히 User History를 LLM에 넣고 다음 콘텐츠를 맞히는 Model이었다면 Netflix가 지난 수년 동안 연구해 온 중요한 부분 하나를 놓치게 됩니다. 바로 Recommendation Objective입니다.
추천 시스템에는 Label이 굉장히 많습니다. 어떤 콘텐츠를 클릭했는지, 얼마나 오래 시청했는지, 중간에 종료했는지, Thumb-up을 눌렀는지 모두 학습 Signal로 사용할 수 있습니다. 하지만 단기적인 Engagement가 높다고 해서 장기적인 Member Satisfaction도 반드시 높아지는 것은 아닙니다. Model이 당장 오래 볼 가능성이 높은 콘텐츠만 반복적으로 추천하면 새로운 콘텐츠를 발견할 기회를 줄일 수 있고, 특정 콘텐츠 유형에 추천이 과도하게 편향될 수도 있습니다.
Netflix가 2023년부터 공개적으로 강조해 온 Reward Innovation이 이 문제를 다룹니다. 관측하기 쉬운 Short-term Engagement를 그대로 최종 목적함수로 사용하는 대신, 회원이 다시 Netflix에 돌아올 가능성이나 더 넓은 Catalog를 탐색하게 만드는 행동처럼 장기적인 만족과 연관된 Signal을 별도의 Reward Model로 추정합니다. GenRec의 Phase 2에서도 이 Reward가 들어갑니다. 크게 보면 Long-term Satisfaction Proxy와 Content / Engagement Type을 Rebalancing하기 위한 Reward를 사용하고, 각 Training Example에 Reward 기반 Weight를 부여합니다. 장기적으로 가치 있는 Engagement에는 Ranking Loss를 더 크게 적용하고, 상대적으로 가치가 낮거나 원하지 않는 행동에는 낮은 Weight를 적용합니다.
여기서도 Netflix는 무조건 복잡한 Reinforcement Learning을 선택하지 않았습니다. 논문에서는 GRPO 같은 RL-style Method가 Preliminary Experiment에서 추가적인 Improvement를 보였지만 Training Overhead가 크기 때문에 현재 GenRec에서는 Reward-weighted Ranking Loss를 주된 Alignment Mechanism으로 사용한다고 설명합니다. 성능뿐 아니라 Stability와 Cost를 함께 본 것입니다.
[7]. GenRec 성능 결과
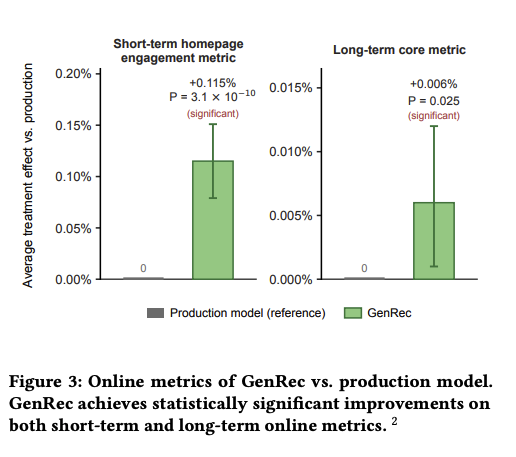
논문의 Figure 3은 실제 Online A/B Test 결과를 보여줍니다. Netflix Traffic의 약 10%를 대상으로 4주 동안 Test를 진행했으며, 테스트 대상은 주요 Batch-compute Surface입니다. GenRec은 Short-term Homepage Engagement Metric에서 Production Model 대비 +0.115%의 Treatment Effect를 기록했고 P-value는 약 3.1×10⁻¹⁰이었습니다. Long-term Core Metric에서도 +0.006%, P-value 0.025로 통계적으로 유의한 Improvement를 보였습니다.

Model과 Data Scaling 결과도 흥미롭습니다. Figure 4에서는 Phase-2 Training Data를 가장 작은 Configuration의 1배에서 2배, 5배, 10배, 20배까지 증가시키는데 약 10B Parameter급 Model의 Normalized Offline Metric이 꾸준히 올라갑니다. 약 1B와 10B급 Backbone을 비교해도 두 Model 모두 Data가 늘어날수록 MRR이 단조롭게 개선됐고, 고정된 Training Budget 조건에서는 큰 Backbone이 작은 Backbone보다 높은 MRR을 보였습니다. Netflix는 여기서 "그러니 가장 큰 Model과 가장 많은 Data를 쓰면 된다"고 결론 내리지 않습니다. Model Size가 커지면 Serving Cost도 증가하고 Phase 2 Data가 커지면 자주 수행해야 하는 Post-training 비용도 증가합니다. 그래서 Data Scaling Curve, Model Scaling Curve, Context Length Ablation을 함께 보고 Quality-Cost Pareto Frontier의 Sweet Spot을 찾는다고 설명합니다.
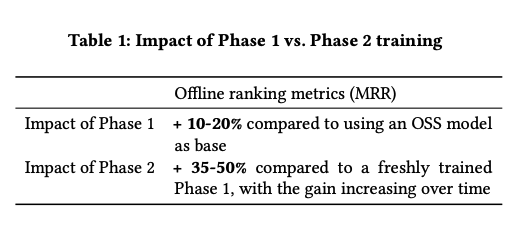
Table 1에서는 Phase 1과 Phase 2가 각각 얼마나 중요한지도 분리해서 측정합니다. 일반 OSS LLM을 바로 Backbone으로 사용하는 것보다 Netflix Data로 학습한 Phase-1 Foundation LLM을 사용하면 Offline Ranking Metric이 약 10~20% 좋아집니다. 즉 Netflix Member와 Content를 미리 학습한 Domain Foundation 자체가 가치를 갖습니다. 그 Foundation Model 위에 Phase-2 Recommendation Post-training을 수행하면 Phase 1 Model이 가장 최신인 시점에도 다시 약 35~50%의 Improvement가 나타납니다. 더 흥미로운 것은 시간이 지나면서 이 차이가 커진다는 것입니다. 약 2주 뒤에는 Phase 2의 상대적 Improvement가 약 80%까지 증가합니다.
이 결과는 Phase 1과 Phase 2를 나눈 이유를 잘 설명합니다. Foundation Model은 범용적인 User / Content Understanding을 담당하기 때문에 상대적으로 느린 Cadence로 업데이트해도 되지만, 콘텐츠의 현재 Popularity와 새로 출시된 Title, 최근 달라진 회원의 관심은 빠르게 변합니다. 시간이 지나면서 Phase 1은 이런 Distribution Change에 대해 Stale해지고, 자주 갱신되는 Phase 2가 그 Gap을 채우는 것입니다.
[8]. GenRec이 보여주는 변화는 ‘추천 모델 하나를 LLM으로 교체했다’보다 크다
GenRec을 단순하게 보면 "기존 Recommendation Model 대신 LLM을 사용했더니 성능이 좋아졌다"는 논문처럼 보일 수 있습니다. 하지만 Netflix가 Discussion에서 직접 강조하는 내용은 조금 다릅니다. 자신들이 보고 있는 변화는 Feature Engineering에서 Context Engineering으로, Customized Architecture에서 Foundation Backbone으로, Classical RecSys Infrastructure에서 LLM Infrastructure로 이동하는 것입니다. 과거에는 Recommendation Task마다 Two-Tower, DLRM 형태의 Feature Interaction Network, Custom Attention, Multi-task Learning 구조 등을 개별적으로 설계했습니다. GenRec이 지향하는 구조에서는 강력한 공통 Foundation Backbone을 먼저 만들고, 각 Application은 어떤 Context를 제공할지, 어떤 Data로 Post-training할지, 어떤 Reward를 사용할지, 어떤 Output Head와 Serving Strategy가 적합한지를 고민합니다. 연구의 중심이 Architecture Engineering에서 한 단계 위의 Data, Context, Post-training, Scaling, Serving Engineering으로 올라가는 셈입니다.
그래서 GenRec을 "LLM이 기존 추천 모델보다 무조건 우월하다는 증거"로 받아들이기보다는, 수년 동안 최적화한 Production Ranker를 상대로 LLM-native Recommendation이 실제 서비스에서도 경쟁력이 있을 수 있다는 것을 꽤 강하게 보여준 사례로 보면 좋을 것 같습니다.
Netflix GenRec에서 개인적으로 중요하게 보는 부분
GenRec의 핵심은 "추천도 LLM으로 한다"가 아니라, 오랫동안 추천 시스템을 지배했던 설계 단위가 바뀌고 있다는 점이라고 생각합니다. Feature를 하나씩 만들고 Task별 Model을 새로 설계하는 대신, 범용적인 User / Content Understanding은 Foundation Model에 축적하고 빠르게 변하는 Recommendation Policy는 Post-training으로 갱신합니다. Context는 제한된 Token Budget 안에서 가장 가치 있는 정보만 남기고, 실제 Ranking에서는 Autoregressive Generation을 사용하지 않습니다. 즉 범용적인 지능은 최대한 재사용하면서 실제 서비스의 Output과 비용 구조는 다시 Task에 맞게 전문화하고 있습니다.
참고 자료
- Ying Li et al. - GenRec: An LLM-Backed Recommendation Ranker at Netflix, arXiv, 2026
- Netflix Technology Blog - Foundation Model for Personalized Recommendation, 2025
- Netflix Technology Blog - Integrating Netflix’s Foundation Model into Personalization Applications, 2025
- Netflix Technology Blog - In-House LLM Serving at Netflix, 2026
- Netflix Technology Blog - Learning a Personalized Homepage, 2015
- Netflix Research - Reward Innovation for Long-Term Member Satisfaction, RecSys 2023
- Netflix Research - Post-Training Generative Recommenders with Advantage-Weighted Supervised Finetuning, 2025
- Netflix Research - Netflix Artwork Personalization via LLM Post-training, 2026
- TypeSafe AI - Introducing System One Models & Jev, 2026
부족한 글이지만 긴 글 읽어주셔서 감사합니다.
혹시라도 저에게 연락을 주시고 싶으시다면,
- Linkedin: https://www.linkedin.com/in/lsjsj92/
- Email: lsjsj92@naver.com
- 블로그 댓글 또는 방명록
으로 부탁드립니다~


